LanTMS v1.1.2 发布 | 深度重构PDF解析,让复杂文档翻译更省心
LanTMS v1.1.2正式发布
专业文档翻译的业务场景持续增多,大量合同、技术手册、多语种资料以 PDF形式流转。文件转换时的版式错乱、表格变形、图文错位,一直是译前处理的高频痛点。LanTMSv1.1.2本次更新,重点升级 LanOCR 文档解析与版式还原能力。新版 LanOCR 优化了PDF底层解析、文字与图形处理、版式重建及Word文档输出流程,提高复杂文档的转换质量,减少后续翻译与排版工作量。
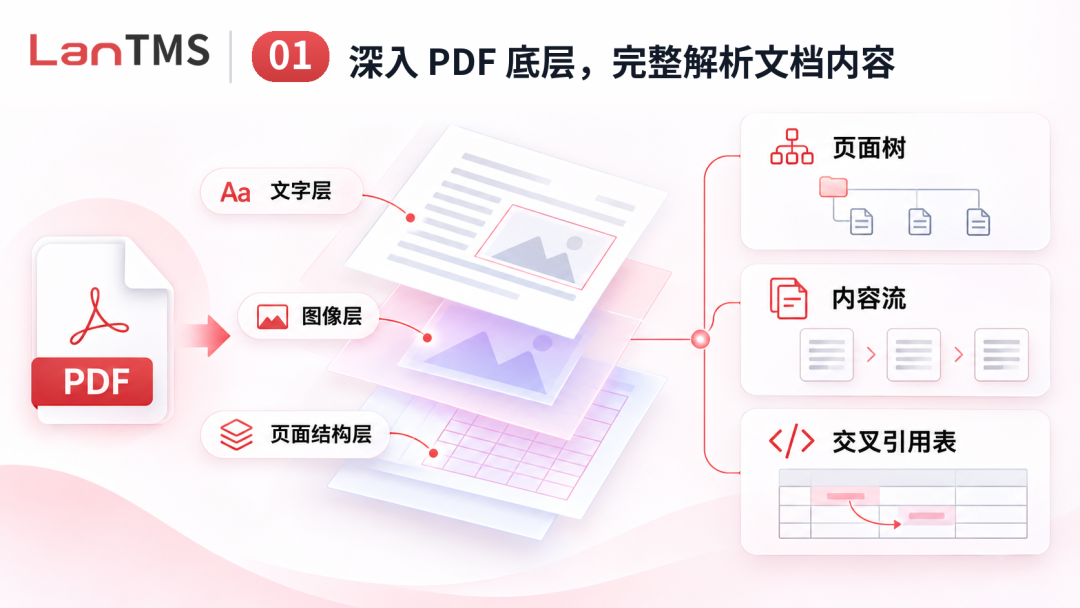
深入PDF底层,完整解析文档内容
PDF的页面显示效果与内部数据结构并不完全一致,直接提取文字容易丢失部分内容及结构信息。新版 LanOCR 深入PDF底层,解析交叉引用表、页面树及内容流,获取页面中的文字、图像、图形及其组织关系,为复杂文档的内容提取和版式还原提供更完整的数据基础。
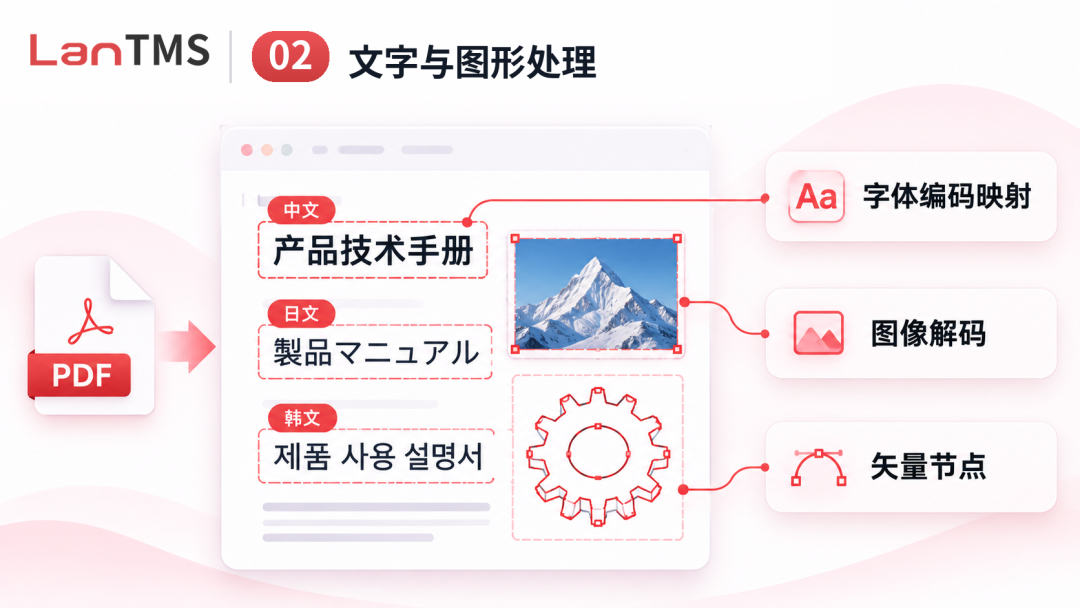
优化文字与图形处理,减少内容丢失
针对多语言混排、特殊字体及复杂图形,LanOCR 优化了嵌入字体解析、文字编码及CJK字符映射处理,改善中文、日文、韩文等文字的提取效果,减少乱码和字符缺失。同时,通过图像解码、色彩空间转换及矢量图形处理,尽可能保留原始图片、图表及图形的清晰度、色彩与细节。
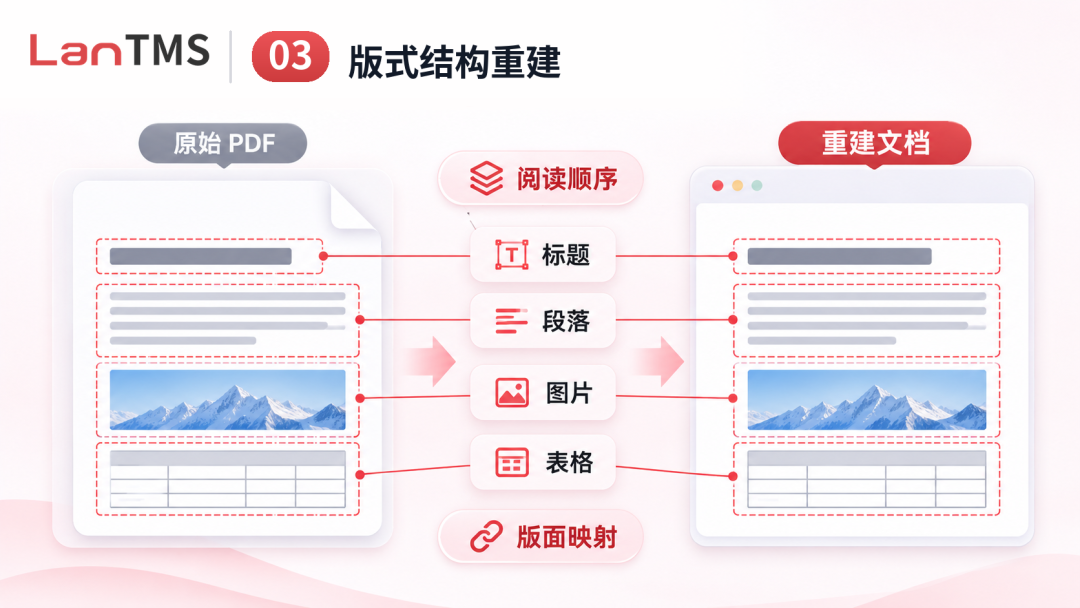
智能重建版式,保留原文排版结构
多栏排版、嵌套表格和图文混排是PDF转换中的常见难点,容易出现段落错位、表格变形及图片位置偏移。新版 LanOCR 对标题、段落、表格、图片及样式进行版面分析,识别各元素的位置与层级关系,并重新组织文档结构。尽可能还原原文的阅读顺序、文字样式和页面布局。
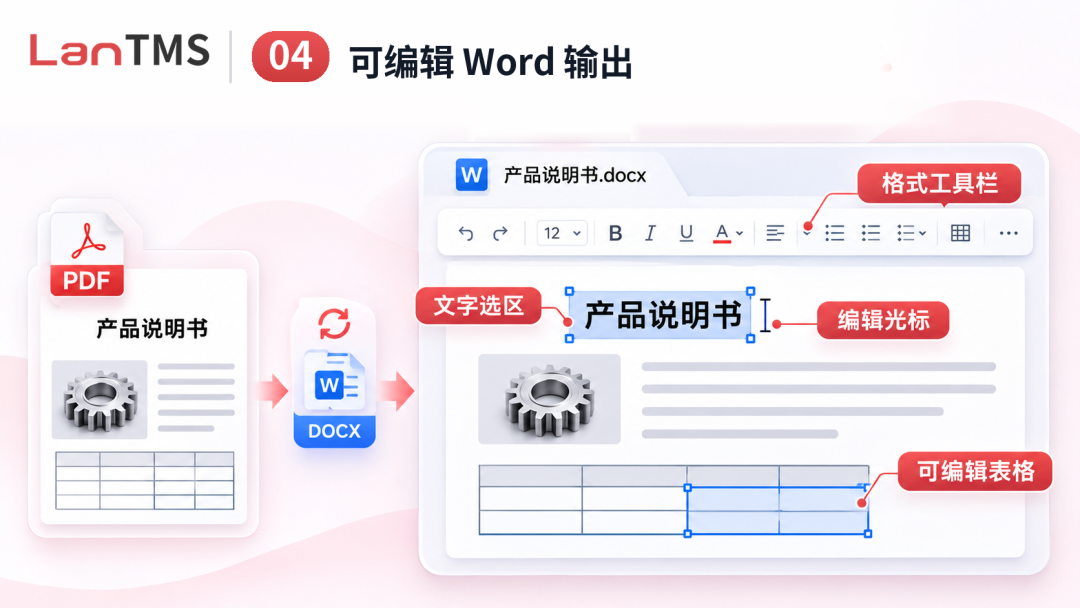
输出可编辑Word,减少后续排版工作
完成内容解析与版式重建后,LanOCR 可将PDF转换为可编辑的Word(DOCX)文档,尽可能保留原有内容及排版。
· 用户可直接修改文字、调整格式,或继续开展翻译与审校工作。
· 对于技术手册、商务合同、产品说明等专业文件,可减少转换后的重复排版和内容整理工作。
让复杂PDF文档处理更高效
本次 LanOCR 升级覆盖PDF底层解析、文字与图形处理、版式结构重建及Word文档输出等关键环节,改善了复杂PDF转换过程中常见的内容缺失、文字乱码和排版错乱问题。升级后的 LanOCR 可更好地处理图文混排、多语言混排及复杂表格等专业文档,减少转换后的格式调整工作,方便用户继续开展翻译、审校及多语言内容交付。